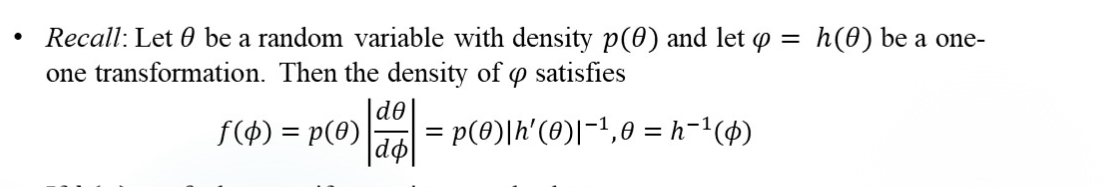贝叶斯统计导论 单参数模型

三节课不学习,赶不上猫咪。(此处鸣谢new bing帮我想的这句话,略作修改。)

回顾

p(θ∣y)=p(θ,y)p(y)=p(θ)p(y∣θ)p(y)∝p(θ)p(y∣θ)p(θ|y)=\frac{p(θ,y)}{p(y)}=\frac{p(θ)p(y|θ)}{p(y)}\propto{p(\theta)p(y|\theta)}

即:Posterior∝Prior∗DatalikelihoodPosterior \propto Prior * Data likelihood,后验正比于先验乘以似然。

先验的分类

有信息先验 Informative prior

先给一个总的表:

Model Prior #Pre
Y∣θ∼B(n,θ)Y|\theta\sim B(n,\theta) θ∼Beta(α,β)\theta\sim Beta(\alpha,\beta) α+β−2\alpha+\beta-2
Y∣θ∼P(θ)Y|\theta\sim P(\theta) θ∼Γ(α,β)\theta\sim Γ(\alpha,\beta) β\beta
Y∣θ∼N(θ,σ2)Y|\theta\sim N(\theta,\sigma^2) θ∼N(μ0,τ02)\theta\sim N(μ_0,τ_0^2) σ2τ02\frac{\sigma^2}{τ_0^2}
Y∣σ2∼N(θ,σ2)Y|\sigma^2\sim N(\theta,\sigma^2) σ2∼Inv−X2(v0,σ02)\sigma^2\sim Inv-\mathcal{X}^2(v_0,\sigma_0^2) v0v_0

Binomial Model

对于生男孩女孩的模型:

Likelihood:p(y∣θ)∝θy(1−θ)n−yPrior:p(θ)∝θα−1(1−θ)β−1,θ∼Beta(α,β)Posterior:p(θ∣y)∝θy+α−1(1−θ)n−y+β−1=Beta(θ∣α+y,β+n−y)Likelihood:p(y|\theta)\propto \theta^y(1-\theta)^{n-y}\\ Prior:p(\theta)\propto \theta^{\alpha-1}(1-\theta)^{\beta-1},\theta \sim Beta(\alpha,\beta)\\ Posterior:p(\theta|y)\propto \theta^{y+\alpha-1}(1-\theta)^{n-y+\beta-1}\\=Beta(\theta|\alpha+y,\beta+n-y)

这样,后验均值和方差为:

E(θ∣y)=α+yα+β+nvar(θ∣y)=E(θ∣y)[1−E(θ∣y)]α+β+n+1E(\theta|y)=\frac{\alpha+y}{\alpha+\beta+n}\\ var(\theta|y)=\frac{E(\theta|y)[1-E(\theta|y)]}{\alpha+\beta+n+1}

从后验的计算可以看出,其实就是预先多看了(α−1)(\alpha-1)个女婴,(β−1)(\beta-1)个男婴。

引出了共轭先验的概念:

If F is a class of sampling distirbutions p(y∣θ)p(y|\theta), and P is a class of prior distributions for θ\theta, then the class P is conjugate for F if:

p(θ∣y)∈Pp(\theta|y)∈P for ALL p(⋅∣θ)∈Fp(·|\theta)∈F and p(⋅)∈Pp(·)∈P.

均值的解释性:

E(θ∣y)=α+yα+β+n=nα+β+nyn+α+βα+β+nαα+βE(\theta|y)=\frac{\alpha+y}{\alpha+\beta+n}\\ =\frac{n}{\alpha+\beta+n}\frac{y}{n}+\frac{\alpha+\beta}{\alpha+\beta+n}\frac{\alpha}{\alpha+\beta}

其实就是数据均值和先验均值的加权平均。

E(θ)=E(E(θ∣Y))E(\theta)=E(E(\theta|Y)):θ的先验均值其实就是所有后验分布均值的平均。

var(θ)=E(var(θ∣Y))+var(E(θ∣Y))⇒var(θ)≥E(var(θ∣Y))var(\theta)=E(var(\theta|Y))+var(E(\theta|Y))\Rightarrow var(\theta)≥E(var(\theta|Y)):后验方差平均上小于先验方差。

Poisson Model

Likelihood:p(y∣θ)∝θnyˉe−nθPrior:p(θ)∝θα−1e−βθ,θ∼Gamma(α,β)Posterior:θ∣y∼Gamma(α+nyˉ,β+n)Likelihood:p(y|\theta)\propto \theta^{n\bar{y}}e^{-n\theta}\\ Prior:p(\theta)\propto \theta^{\alpha-1}e^{-\beta\theta},\theta \sim Gamma(\alpha,\beta)\\ Posterior:\theta|y\sim Gamma(\alpha + n\bar{y},\beta+n)

然后先验信息量是β的原因是,Prior中β位置和似然中n位置一样。

Normal Mean with Known Varivance

Likelihood:p(y∣θ)=12πσe−12σ2(y−θ)2Prior:p(θ)=eAθ2+Bθ+C即p(θ)∝e−12τ02(θ−μ0)2Posterior:θ∣y∼N(μ1,τ12)Likelihood:p(y|\theta)=\frac{1}{\sqrt{2π}σ}e^{-\frac{1}{2σ^2}(y-\theta)^2}\\ Prior:p(\theta)=e^{A\theta^2+B\theta+C}\\ 即p(\theta)\propto e^{-\frac{1}{2τ_0^2}(\theta-μ_0)^2}\\ Posterior:\theta|y\sim N(μ_1,τ_1^2)

其中,计算得到:

μ1=1τ02μ0+1σ2y1τ02+1σ21τ12=1τ02+1σ2μ_1=\frac{\frac{1}{τ_0^2}μ_0+\frac{1}{\sigma^2}y}{\frac{1}{τ_0^2}+\frac{1}{\sigma^2}}\\ \frac{1}{τ_1^2}=\frac{1}{τ_0^2}+\frac{1}{\sigma^2}

其中第二行是:后验精度=先验精度+数据精度。

当观测到多个y时,变为:

μn=1τ02μ0+nσ2yˉ1τ02+nσ21τ12=1τ02+nσ2μ_n=\frac{\frac{1}{τ_0^2}μ_0+\frac{n}{\sigma^2}\bar{y}}{\frac{1}{τ_0^2}+\frac{n}{\sigma^2}}\\ \frac{1}{τ_1^2}=\frac{1}{τ_0^2}+\frac{n}{\sigma^2}

由数据精度的计算:nσ2\frac{n}{\sigma^2}可以推测,先验精度n0σ2=1τ02\frac{n_0}{\sigma^2}=\frac{1}{τ_0^2},自然有先验样本量为σ2/τ02σ^2/τ_0^2

预测时:

由于y~∣θ∼N(θ,σ2)\tilde{y}|\theta\sim N(\theta,\sigma^2),θ∣y∼N(μ1,τ12)\theta|y\sim N(μ_1,τ_1^2),又由于yy和y~\tilde{y}独立,所以y~∣θ,y∼N(θ,σ2)\tilde{y}|\theta,y\sim N(\theta,\sigma^2)。

接着,把∣y|y遮掉,相当于θθ边缘是正态,y~∣θ\tilde{y}|\theta是正态,且结果是θ\theta的线性函数,所以它们的联合分布(y~,θ)(\tilde{y},\theta)也是正态,于是边缘y~\tilde{y}是正态,最后加上条件y,就是y~∣y\tilde{y}|y是正态。

(第一行,第一个是带条件的重期望,第二个是上面结论):

E(y~∣y)=E(E(y~∣θ,y)∣y)=E(θ∣y)=μ1var(y~∣y)=E(var(y~∣y,θ)∣y)+var(E(y~∣y,θ)∣y)=σ2+τ12E(\tilde{y}|y)=E(E(\tilde{y}|\theta,y)|y)=E(\theta|y)=μ_1\\ var(\tilde{y}|y)=E(var(\tilde{y}|y,\theta)|y)+var(E(\tilde{y}|y,\theta)|y)=\sigma^2+τ_1^2

Normal Varivance with Known Mean

这一部分的推导有点难。直接上多个观测值的推导:

Likelihood:p(y∣σ2)∝σ−ne−12σ2∑i=1n(yi−θ)2=(σ2)−n/2e−n2σ2v其中 v=1n∑i=1n(yi−θ)2Likelihood:p(y|\sigma^2)\propto \sigma^{-n}e^{-\frac{1}{2σ^2}\sum_{i=1}^{n}(y_i-\theta)^2}=(\sigma^2)^{-n/2}e^{-\frac{n}{2\sigma^2}v}\\ 其中\ v=\frac1n\sum_{i=1}^n{(y_i-\theta)^2}\\

从这个似然,想到构建共轭先验的时候,是类似于xαe−β2xx^\alpha e^{-\frac{\beta}{2x}}的形式。而Gamma分布是xα−1e−βxx^{\alpha-1}e^{-\beta x}的形式,所以令z=1/xz=1/x,fz(z)=f(x)1z2=z−(α+1)e−βzf_z(z)=f(x)\frac{1}{z^2}=z^{-(\alpha+1)}e^{-\frac{\beta}{z}},称为逆Gamma分布,即Inv−Γ(α,β)Inv - Γ(\alpha,\beta)。

又由Gamma和卡方的关系,Γ(v0/2,1/2)=Xv02Γ(v_0/2, 1/2)=\mathcal{X}^2_{v_0},所以也可以找到逆卡方分布的形式。

Conjugate Prior:p(σ2)∝(σ2)−(α+1)e−βσ2可写成 p(σ2)∝(σ2)−(v02+1)e−v0σ22σ2Conjugate\ Prior:p(\sigma^2)\propto (\sigma^2)^{-(\alpha+1)}e^{-\frac{\beta}{\sigma^2}}\\ 可写成\ p(\sigma^2)\propto (\sigma^2)^{-(\frac{v_0}{2}+1)}e^{-\frac{v_0\sigma^2}{2\sigma^2}}\\

这样凑出了:

σ2∼Inv−Γ(α,β)σ2∼Inv−X2(v0,σ02)σ2=σ02v0X,X∼Xv02\sigma^2 \sim Inv -Γ(\alpha,\beta)\\ \sigma^2 \sim Inv-\mathcal{X}^2(v_0,\sigma_0^2)\\ \sigma^2=\frac{\sigma_0^2v_0}{X},X\sim \mathcal{X}^2_{v_0}

于是后验:

Posterior:σ2∣y∼Inv−X2(v0+n,v0σ02+nvv0+n)Posterior:\sigma^2|y\sim Inv-\mathcal{X}^2(v_0+n,\frac{v_0\sigma_0^2+nv}{v_0+n})

对比一下,v0v_0就是先验信息量,而nvnv是样本总方差,v0σ02v_0\sigma_0^2就是先验总方差。

无信息先验 Non-infomative Prior

在Normal Mean with Known Variance中,如果τ02τ_0^2趋于无穷,相当于先验样本量为0。这个时候先验不是一个"proper distribution"(恰当的分布,简单地说就是积分为1),但后验是恰当的。这是一种得到无信息先验的办法,但并不总是有效。

无信息先验并不一定是均匀分布,例如在Normal Variance with Known Mean中,找p(σ)∝1p(\sigma)\propto 1,根据下面公式:

算出p(σ2)∝12σp(\sigma^2)\propto \frac{1}{2\sigma}。

Jeffrey’s Prior

这就引出一个问题:

Can we pick a prior where the scale the parameter is measured in doesn’t matter?

答案是Jeffrey’s Prior,具有不变性:

对于参数θ,先验是pθ(θ)=π(θ)p_\theta(\theta)=\pi(\theta),一一映射到ϕ=h(θ)\phi=h(\theta),先验变为pϕ(ϕ)=pθ(θ(ϕ))∣dθ(ϕ)dϕ∣=η(ϕ)p_\phi(\phi)=p_\theta(\theta(\phi))|\frac{d\theta(\phi)}{d\phi}|=\eta(\phi)。Jeffery’s invariance principle能使得π(⋅)=η(⋅)\pi(·)=\eta(·),也就是希望η(ϕ)=π(ϕ)\eta(\phi)=\pi(\phi)。

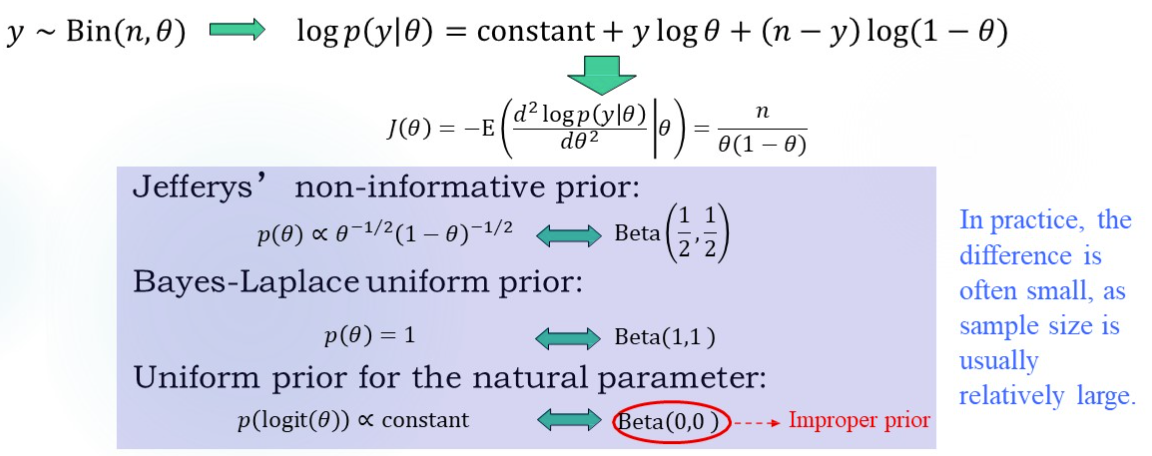
借助了Fisher信息量(对y求期望):

J(θ)=−E(d2logp(y∣θ)dθ2∣θ)J(\theta)=-E(\frac{d^2logp(y|\theta)}{d\theta^2}|\theta)

Jeffrey’s Prior是:

p(θ)∝[J(θ)]1/2p(\theta)\propto [J(\theta)]^{1/2}

有(推导过程略,复习时应该看一下):

J(ϕ)1/2=J(θ)1/2∣dθdϕ∣J(\phi)^{1/2}=J(\theta)^{1/2}|\frac{d\theta}{d\phi}|

对于Normal model with unknown variance,p(σ)∝1σp(\sigma)\propto \frac1\sigma,p(σ2)∝1σ2p(\sigma^2)\propto\frac1{\sigma^2},计算p(logσ)p(log\sigma):

不能想当然地认为是1logσ\frac1{log\sigma},相当于f(1)=1,f(2)=12f(1)=1,f(2)=\frac12并不能说明f(3)=13f(3)=\frac13(也就是说你不知道π(⋅)\pi(·)的形式)。应该根据Jeffrey先验的性质:

p(logσ)=p(σ)∣dσdlogσ∣∝1p(log\sigma)=p(\sigma)|\frac{d\sigma}{dlog\sigma}|\propto1

Binomial Model的结论:

Pivotal Quatities枢轴量

枢轴量的分布与参数无关。

在y∼N(θ,1)y\sim N(\theta, 1)的模型中,令u=y−θu=y-\theta,u就是一个枢轴量。

我们希望f(u∣y)∝1⋅f(u∣θ)f(u|y)\propto 1 ·f(u|\theta),对比p(θ∣y)∝p(θ)p(y∣θ)p(\theta|y)\propto p(\theta)p(y|\theta),结合概率密度的变换公式可以算出p(θ)∝1p(\theta)\propto1。

例如在y∼N(0,θ2)y\sim N(0,\theta^2)的模型中,u=yθu=\frac{y}{\theta}是枢轴量,计算出p(θ)∝1θp(\theta)\propto \frac1\theta。


贝叶斯统计导论 单参数模型
https://bebr2.com/2023/03/11/贝叶斯统计导论 单参数模型/
作者
BeBr2
发布于
2023年3月11日
许可协议